AI Rap 视频生成器
用一张人物照片搭配已有说唱录音,生成单人 Rap 表演。支持 1–10 秒含人声的音频,也可以先试用默认照片与示例。当前为测试版。
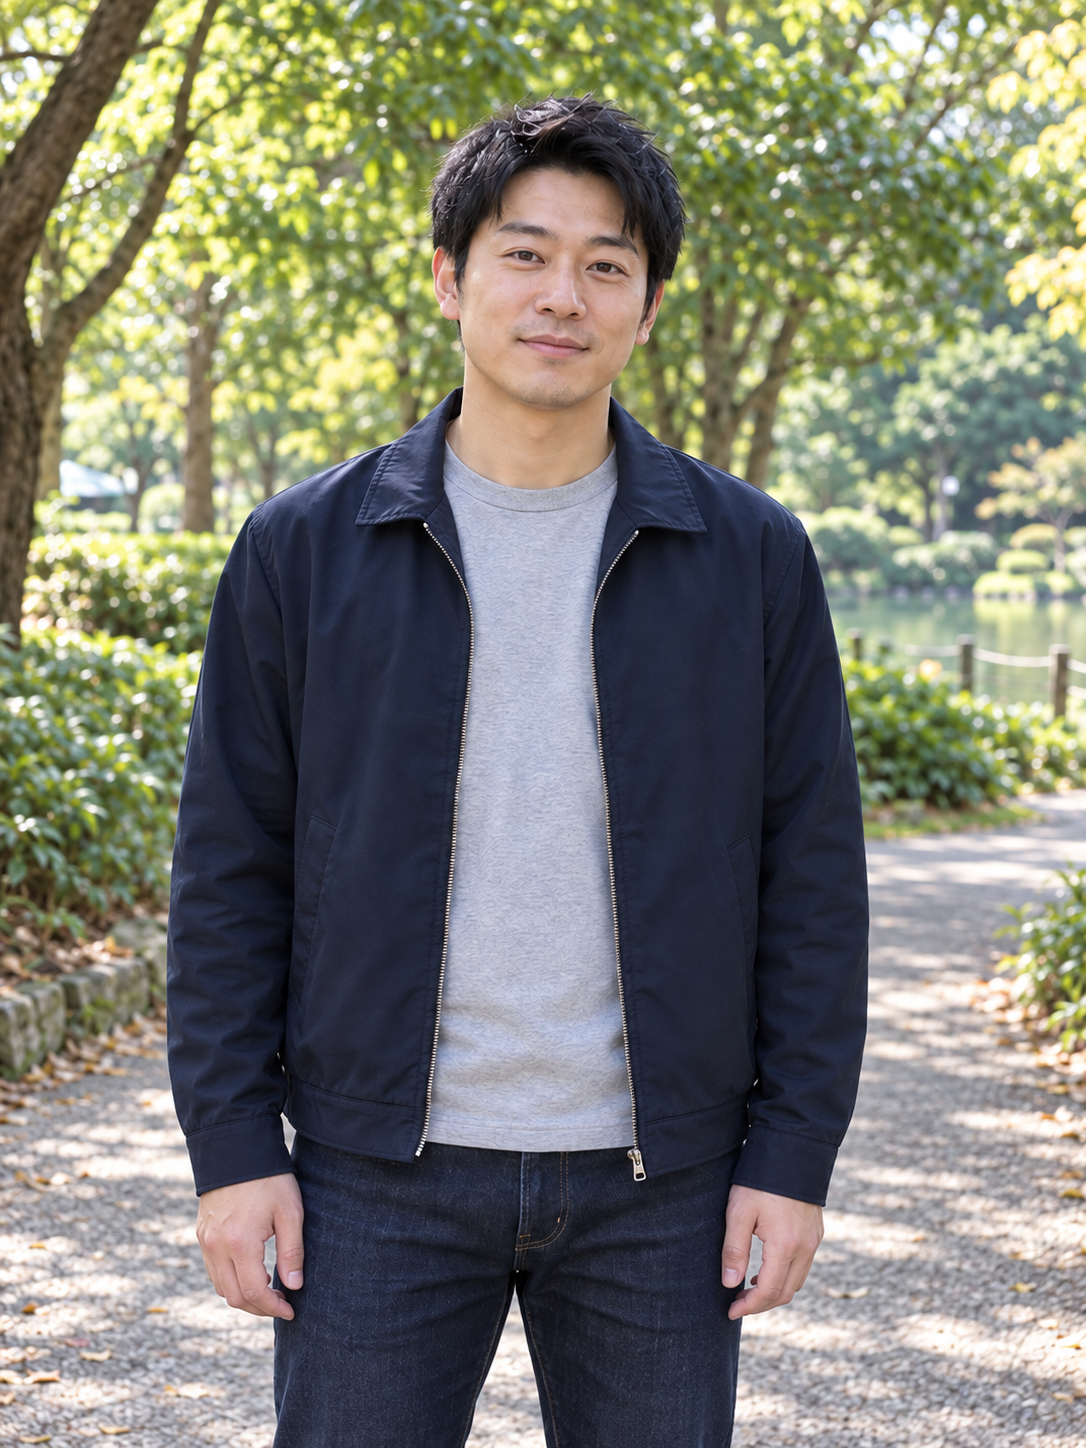
人物照片
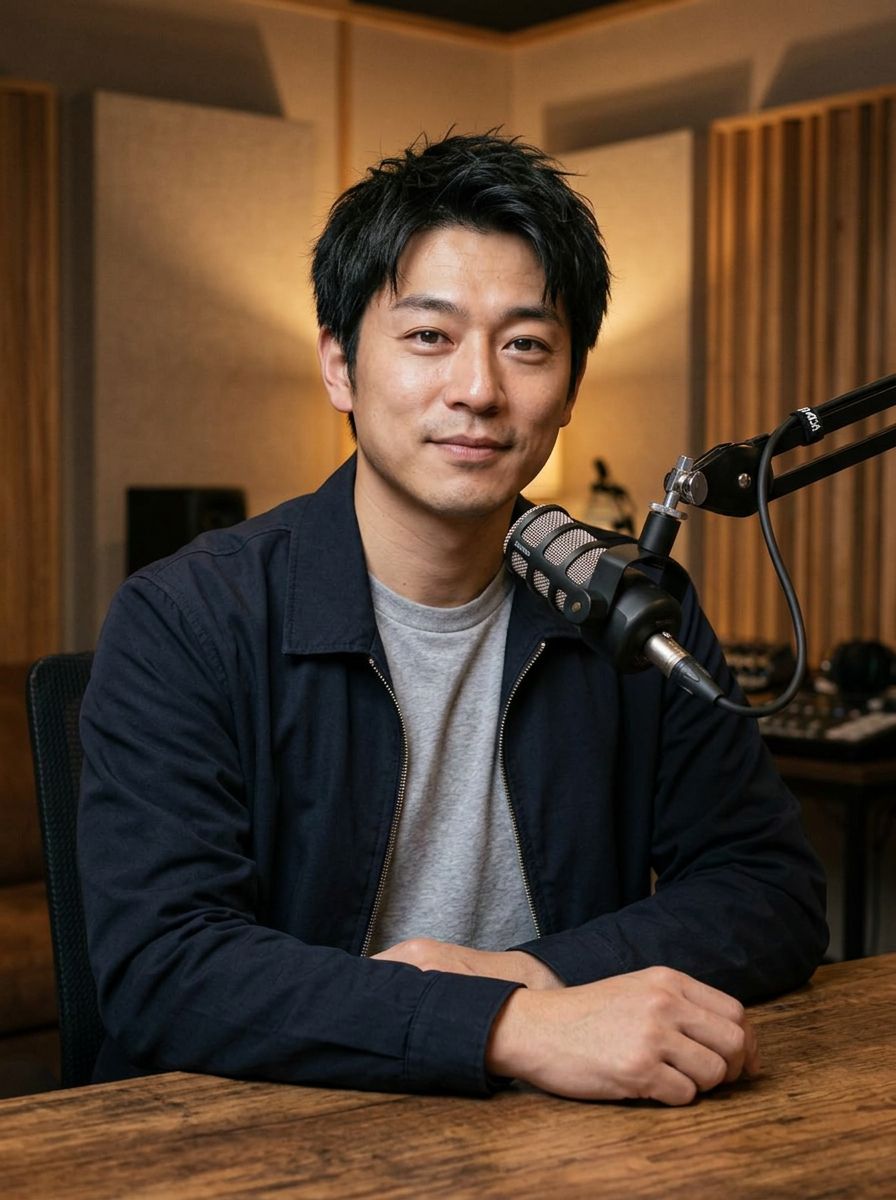
真实生成示例 · 点击带声音播放
使用默认人物生成的真实测试结果。示例音频为英语,切换界面语言不会翻译音频。请检查字幕、口型与人物一致性。
录好一句 Rap,让照片跟着节奏表演
已经有一段说唱小样,却还没有合适的出镜画面时,可以先从一张照片试起。这里把已有声音变成短表演的参考,适合验证一句歌词的视觉感觉。
照片确定出镜的人物
输入一张成年人的清晰人像,模型会围绕单人说唱生成点头、口部动作和适度手势。目标是一段连续的短表演,不是多场景音乐 MV。
录音提供歌词、节奏和声音
你上传的 Rap 录音决定听到的表演内容。工具不会根据一句主题自动写词、作曲或把声音替换成照片人物的音色;准备好想呈现的声音很重要。
先看最有辨识度的一句
当完整歌曲尚在制作时,选一个能独立听懂的短句作为尝试。比起塞进整段主歌,短句更方便判断表情、节奏和人物是否适合后续作品。
先剪出一句完整的人声,再上传
一段好用的输入通常有清楚的主唱、完整的开头结尾,以及可以辨认的节奏。素材准备影响可判断程度,但不能保证口型精确同步。
让说唱人声清楚可听
优先选一位主要表演者的片段,避免多人同时抢词、伴奏盖住人声或长时间没有歌词。只有伴奏无法提供清晰的说唱发音参考。
把音频整理为短文件
支持 1–10 秒的 MP3、WAV 或 FLAC,最大 20 MB。先在外部工具中裁掉长前奏和空白,保留完整词句;不要从一个字中间开始或结束。
让照片里的嘴部保持可见
使用一张 JPG、PNG 或 WebP 成年人照片。建议正面或轻微侧脸、脸部清晰,避免麦克风、手或头发遮嘴;保留一些肩部空间有助于观察表演。
把准备好的照片和 Rap 放到一起
可以先用默认人物和英语示例音频理解流程,再分别替换成自己的素材。更换照片不会自动改变音频里的声音。
选定一位出镜人物
上传单人人像或使用默认照片。确认预览中的人脸完整,没有多个人物争夺画面中心。
加入 1–10 秒说唱录音
选择示例或上传含人声的 Rap 文件,先试听确认版本正确。系统会根据音频实际时长选择能容纳它的生成档位。
生成并带声音检查
登录、确认积分报价后生成。比较人声重音与可见动作,检查人物、口型和手部;确认可用再下载,加入自己的预告或剪辑。
两个人合演,或唱一段旋律?
先确认你要表达的是单人说唱、双人互动,还是旋律演唱。这三个需求的输入方式并不相同。
有自己的 Rap 录音时
继续使用当前单人入口,可以替换录音。若希望两张照片同框,AI 双人 Rap 使用固定参考音频与动作,不能带入自己的这段 Rap。
录音以旋律和长音为主时
AI 照片唱歌面向含人声的歌曲片段,动作更围绕旋律和乐句。普通讲话则可选择照片口播,并按需要使用文字模式。
常见问题
了解输入如何影响结果,以及下载前需要检查什么。